動画・音声から無料で字幕を自動生成|ブラウザ完結・アップロード不要の Whisper 字幕ガイド
VideoBuff の自動字幕生成機能を技術背景・操作手順・他ツールとの違いまで含めて完全解説。OpenAI Whisper Large v3 Turbo をブラウザ内で動かし、音声をアップロードせずに日本語・英語の字幕に変換します。会議の議事録字幕、ポッドキャスト書き起こし、インタビュー動画の字幕付け、ショート動画 (9:16) のキャプション付けなど、機密性の高い音源にも安心して使える設計。単語ごとに色が変わるカラオケ字幕、Claude 連携での英語などへの翻訳、SRT / VTT / TXT 形式のダウンロード、推論中のライブプレビューにも対応。WebGPU が使えるブラウザ(Chrome / Edge)で動作します。
なぜブラウザ完結なのか — 仕組みとプライバシー
字幕生成サービスの多くは、音声をいったんクラウドへアップロードしてから AI で処理します。便利ですが、社内会議・インタビュー・取材音源・個人的な記録などを扱うときは、外部のサービスに渡すこと自体を避けたい場合があります。NDA を結んでいる取材音源、医療や法務の会話、未公開の社内の議論など、用途によっては「外に出さない」ことが条件になります。
VideoBuff の自動字幕は、OpenAI Whisper Large v3 Turbo を ONNX にしたモデルを、Hugging Face Transformers.js でブラウザの中で動かします。音声はブラウザのメモリの中だけで処理し、どこにも送りません。できた字幕の文字も送りません。
ネットワークを使うのは、モデルを取り寄せるときだけです。初回は、モデルのファイル(約 1.6GB)を Hugging Face から、モデルを動かすためのプログラムを jsDelivr(配信用のサーバー)からダウンロードし、ブラウザのキャッシュ(Cache API)に保存します。2 回目以降はキャッシュから読み込むので、ダウンロードを待たずに始まります。パソコンの空き容量が少なくなったときなどにブラウザがキャッシュを消すことがあり、その場合はもう一度ダウンロードします。
このほか、サイト全体で使っているアクセス解析(Google Analytics)に、字幕の生成に失敗したときのエラーの内容が送られることがあります。音声や字幕の文字は含みません。
字幕の自動生成には WebGPU が必要です。WebGPU が使えるブラウザ(Chrome / Edge)では、GPU で処理します。WebGPU が使えない環境では、モデルがメモリに載らず、字幕を作れません。
使い方
- タイムラインで、字幕を付けたい動画クリップか音声クリップを選びます
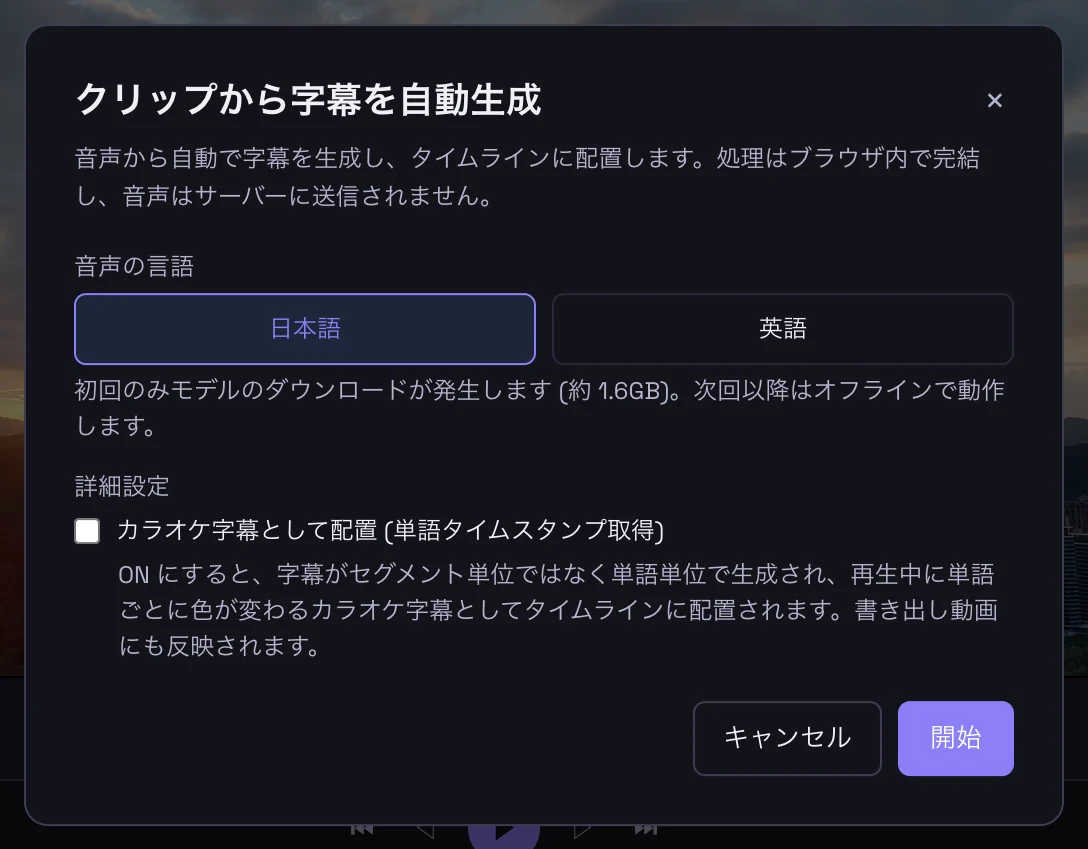
- インスペクターの「字幕生成」にある「字幕生成…」ボタンを押します
- 「音声の言語」(日本語 / 英語)を選びます。字幕は話している言語のまま作ります
- 単語ごとに色が変わる字幕にしたいときは、「詳細設定」で「カラオケ字幕として配置」を ON にします
- 「開始」を押します。初回は「モデルをダウンロード中…」と進み具合が表示され、続いて「字幕を生成中…」で経過時間と残りの目安が表示されます
- できた字幕を一覧で確かめ、直したい行はクリックして修正、要らない行は × で消します
- 「タイムラインに追加」(カラオケ字幕は「カラオケ字幕を追加」)を押すと、字幕が新しいテキストトラックに並びます
字幕生成の画面を開いた時点で、モデルの準備(初回はダウンロード)が裏で始まります。
Claude 連携を使っているなら、「この動画に字幕を付けて」と頼むこともできます。言語やカラオケ字幕も、ことばで指定できます。「英語の字幕に」と頼めば、Claude が字幕を訳して書き換えます(英語以外の言語にもできます)。字幕を置いたあとの、言い回しや位置の手直しも続けて引き受けます。
使用モデル — Whisper Large v3 Turbo
Whisper Large v3 Turbo という多言語モデル 1 つで動かしています。Whisper Large v3 のデコーダの層を 32 から 4 に減らして速くしたモデルで、パラメータ数は 809M です。日本語・英語ともに実用的な精度で、固有名詞の多い取材音源や長いインタビューにも使えます。
以前は「高速(Whisper Small)」と「高品質(Turbo)」の 2 段階を選べましたが、軽いモデルで試してから高品質でやり直す手間のほうが大きいため、Turbo 1 つにまとめました。モデルを選ぶ必要はありません。
初回だけ約 1.6GB のモデルをダウンロードします。カラオケ字幕では、単語ごとの時刻を取り出せる別の版のモデルを使うため、初めてカラオケ字幕を作るときに同じくらいの大きさのダウンロードがもう 1 回あります。
WebGPU が使えるブラウザ(Chrome / Edge)では GPU で処理します。はっきりした話し方で雑音の少ない録音ほど精度が上がり、複数の人の声が重なる、専門用語がとても多い、録音環境が悪い、といった条件では誤りが増えます。生成後に手で直す前提で使うのが現実的です。
英語など、ほかの言語の字幕
字幕は、話している言語のまま作ります。字幕に使っている Whisper Large v3 Turbo は速さを優先したモデルで、翻訳には対応していません。
英語など、ほかの言語の字幕が欲しいときは、Claude 連携で「この字幕を英語にして」と頼んでください。Claude が字幕を 1 行ずつ訳して書き換えます。表示の時間はそのままで、英語に限らず、中国語や韓国語などにもできます。文脈を読んで訳すので、話し言葉や専門用語も自然な字幕になります。
元の言語の字幕も残したいときは、先に字幕をもう一度作って(「タイムラインに追加」を押すたびに新しいテキストトラックに並びます)、片方だけを訳してもらえば、2 つの言語の字幕が並びます。
字幕の編集とダウンロード
生成が終わると、字幕が一覧で表示されます。各行をクリックして文字を直し、× で要らない行を消せます。タイムラインに置く前にここで整えておくと、後の手直しが減ります。
字幕ファイルが欲しいときは、一覧の下から SRT・VTT・TXT のいずれかでダウンロードできます(通常の字幕のとき。カラオケ字幕ではダウンロードは出ません)。SRT は YouTube や多くのプレイヤーが読める字幕の形式、VTT は Web ページの動画(HTML5 の track 要素)で使う形式、TXT は時刻のない文字起こしです。
「タイムラインに追加」を押すと、字幕が新しいテキストトラックに並びます。画面の縦横比(16:9 / 9:16 など)に合わせて、文字の大きさと 1 行の長さを自動で決め、長い文は複数の字幕に分けます。置いたあとは普通のテキストクリップと同じく、位置・色・縁取り・フォント・トランジションをインスペクターで変えられます。
ライブプレビュー
生成中は、できた字幕がその場で表示されていきます。最後まで待たなくても、どこまで進んだか、冒頭の聞き取りがうまくいっているかが分かるので、設定を変えてやり直すかどうかを早めに決められます。長い音声ほど役に立ちます。
Whisper は音声を 30 秒ずつ、前後を少し重ねながら処理します。生成中の表示はその途中の結果をそのまま出しているため、文が途中で切れたり重なったりして見えることがあります。完了時にすべてをつなぎ合わせ、重なりを取り除いて整えるので、最終的な字幕には影響しません。
カラオケ字幕モード — 単語ごとに色が変わる字幕
字幕生成の画面の「詳細設定」で 「カラオケ字幕として配置」 を ON にすると、再生に合わせて単語ごとに色が変わる字幕 を作れます。ショート動画で定番の表現を、ブラウザの中だけで、自動・無料で作れます。
通常の字幕はひとまとまりの文ごとに 1 つのテキストクリップを置きますが、カラオケ字幕は 1 行ずつ短いクリップに分け、それぞれに単語ごとの話し始めの時刻を持たせます。再生位置がその時刻に来ると、その文字が指定した色に変わります。
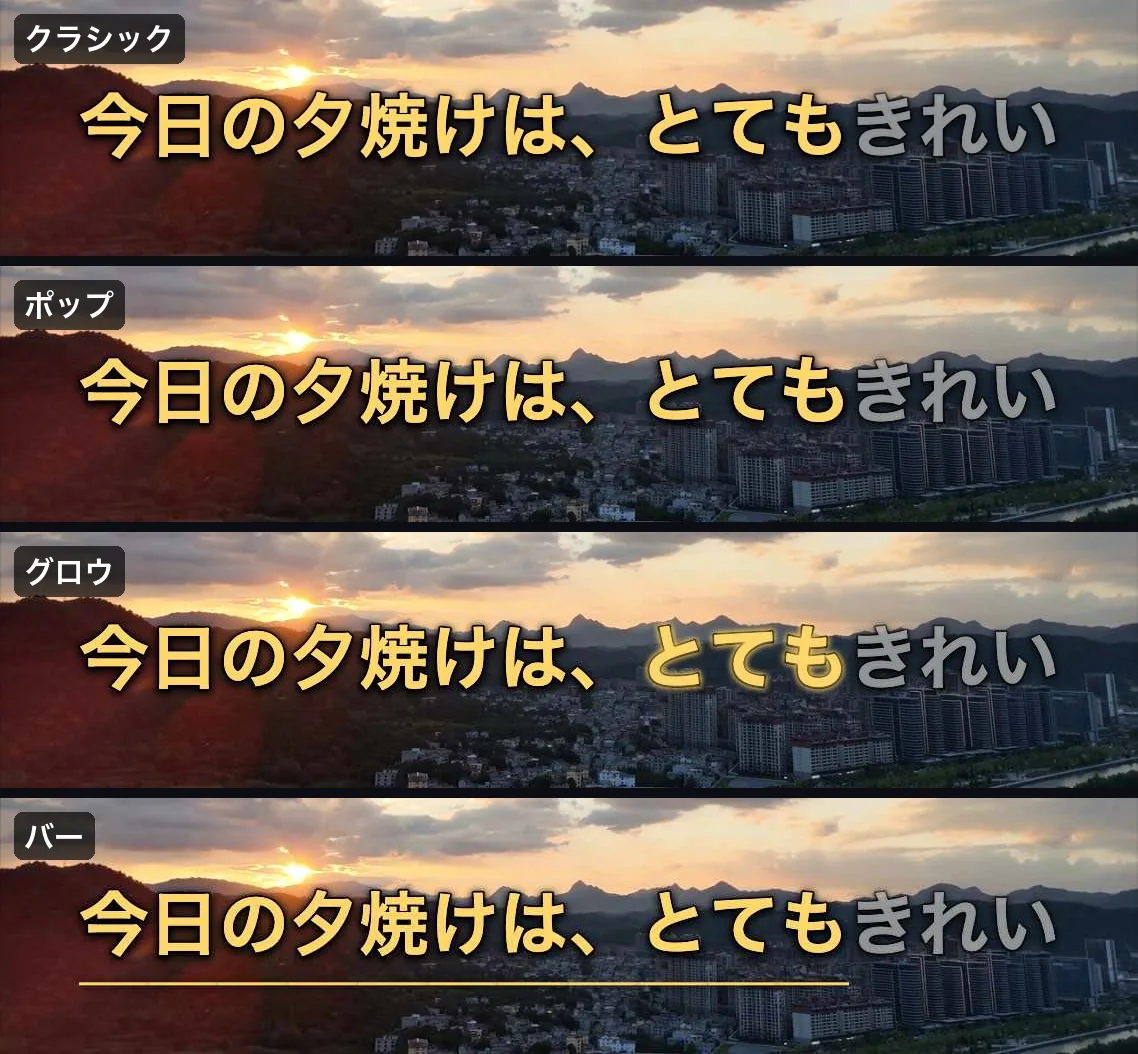
4 つの表示 — 生成するときに「カラオケ表示」で選べます(あとからインスペクターでも変えられます)。
- クラシック: 話し終えた単語が指定した色のまま残る、カラオケらしい塗りつぶし
- ポップ: 話している文字が一瞬大きくなって弾む
- グロウ: 話している文字のまわりが指定した色で光る
- バー: 話し終えた文字の下に、指定した色の線が左から右へ伸びる
色(「カラオケ色」)も生成するときに選べ、すべての字幕にまとめて使われます。あとから各クリップのインスペクターで「カラオケ色」「カラオケ表示」を個別に変えられます。
仕組みと精度 — Whisper の単語ごとの時刻(return_timestamps: 'word')を使います。Whisper が出すのは単語単位の時刻までなので、1 つの単語の中では、長さを文字数で均等に割って各文字が変わる時刻を決めています。日本語では、Whisper がいくつかの文字のまとまりを 1 語として出すため、文節ごとに自然なリズムで色が変わります。
早口や雑音の多い音声では、単語の時刻がずれることがあります。話し声と音楽が重なった素材は苦手です。認識の誤りやずれが目立つときは、タイムラインに置く前に結果の一覧で行ごとに直すか消してください。
プレビューと書き出しで同じ見た目 — プレビューと書き出しは同じ時刻の計算と色の決め方を使っているので、ほぼ同じ見た目になり、書き出した動画にもカラオケの効果がそのまま入ります。
速度のヒント
初回はモデルのダウンロードに時間がかかりますが、2 回目以降はブラウザのキャッシュからすぐに始まります。WebGPU が使えるブラウザ(Chrome / Edge)では生成そのものも速くなります。
字幕を作るのは、選んだクリップの使っている範囲(トリムした範囲)だけです。長い録音は、先に要らない部分を削っておくと処理時間が短くなります。
会議の録音などで前後に長い無音があるときは、Claude 連携で「クリップの前後の無音を切って」と頼んでから字幕を作ると、字幕を作る範囲が短くなり、処理も早く終わります。
他の字幕自動生成ツールとの違い
字幕の自動生成はいまや多くの動画編集ソフトやサービスにあります。VideoBuff の特徴は次の組み合わせです。
ブラウザだけで完結する クラウド型のサービスの多くは、音声をサーバーにアップロードして処理します。VideoBuff はインストールもアカウントも不要で、ページを開けばブラウザの中だけで字幕を作れます。
動画編集とひとつながり Whisper をブラウザで試せる字幕作成だけのツールでは、できた SRT や VTT を別の編集ソフトに取り込む手間がかかります。VideoBuff では生成した字幕がそのままタイムラインに並び、フォント・色・位置・トランジションをインスペクターで直せます。
無料で使える VideoBuff の字幕生成は無料で、利用時間や回数の上限はありません。処理に使うのは、お使いのパソコンの計算能力だけです。
送っていないことを確かめられる 音声を外に送る仕組みそのものが無いので、ブラウザの開発者ツールの「ネットワーク」タブで、音声が送られていないことを自分で確かめられます。NDA のある案件、医療・法務、社内会議などで重要になります。
トレードオフ 手元のパソコンで動かす分、話者の聞き分けや、固有名詞を登録できる辞書といった高度な機能はありません。精度を最優先にしつつ音声を外に出したくない場合は、自分で用意したサーバーで Whisper を動かすなど、ブラウザの外の方法が次の選択肢になります。
よくある質問
Q. 商用利用はできますか? A. はい。生成した字幕に VideoBuff の利用料や利用の制限はありません。使っている Whisper のモデルは MIT ライセンスです。詳しくはOSS ライセンスページの「ランタイムで取得する機械学習モデル」を参照してください。
Q. 何分の音声まで処理できますか? A. 決まった上限はありませんが、長い音声ほど時間とメモリを使います。1 時間を超えるような録音は、要る部分だけにクリップをトリムしてから実行するのがおすすめです(トリムした範囲だけを処理します)。
Q. WebGPU が無いブラウザでも動きますか? A. 動きません。字幕の自動生成には WebGPU が必要です。WebGPU が使えない環境では、モデルがメモリに載らず、メモリ不足の表示が出て字幕を作れません。WebGPU が使える Chrome / Edge でお使いください。なお Safari では、Safari の不具合でページが落ちてしまうため、字幕の自動生成は使えません。
Q. ほかの言語の字幕は作れますか? A. 選べる音声の言語は日本語と英語で、字幕は話している言語のまま作ります。英語などほかの言語の字幕は、Claude 連携で Claude に訳してもらうか、字幕を SRT で書き出してから翻訳ツールで訳してください。
Q. 音声データはどこに保存されますか? A. ブラウザのメモリの中だけで扱い、VideoBuff のサーバーや Hugging Face を含むどの外部サービスにも送りません。ダウンロードして保存するのはモデルのファイル(と動かすためのプログラム)だけで、これは通常の Web のキャッシュと同じくブラウザの Cache API に入ります。
Q. スマートフォンやタブレットでも使えますか? A. VideoBuff のエディタはパソコンのブラウザ向けで、画面の幅が狭いスマートフォンでは開けません。iPhone・iPad では、どのブラウザでもエディタを開けません。モデルのダウンロードの大きさ(約 1.6GB)と処理の重さからも、パソコンでの利用をおすすめします。
Q. 縦動画 (9:16) のショート動画でも使えますか? A. 使えます。画面の縦横比に合わせて字幕の文字の大きさと 1 行の文字数を自動で決めるので、9:16 では 1 行が短めに分かれ、画面からはみ出しにくくなっています。
Q. 字幕の精度を上げるコツは? A. いちばん効くのは録音です。マイクを話す人に近づけ、周りの雑音を抑えてください。字幕はクリップの元の音声から作るので、VideoBuff で音声クリップにかけた EQ やコンプレッサーは字幕の精度には影響しません。すでにある録音の雑音を減らしたいときは、別の音声編集ソフト(姉妹サービスの AudioBuff など)で整えてから取り込んでください。モデルは 1 種類なので、モデルを選び直す必要はありません。
字幕生成ボタンが出ない場合 (応用)
字幕生成は音声から作る機能なので、インスペクターの「字幕生成」は、選んだクリップに字幕を作れる音声があるときだけ表示されます。
音声クリップを選んだとき いつも表示されます。字幕は音声クリップの位置に合わせて置かれます。
動画クリップを選んだとき(音声とリンクしている) 動画を取り込んだ直後はこの状態です。リンクしている音声を使い、字幕は動画クリップの位置に合わせて置かれます。ふつうはこれで十分です。
動画クリップを選んだとき(分離した、またはリンクしていた音声を消した) 「字幕生成」は表示されません。映像と音声が別々になっていると、字幕をどちらの位置に合わせればよいか決められないためです。分離したあとも音声クリップが残っていれば、その音声クリップを選んで ください。字幕は音声の位置に置かれるので、音とずれません。 動画のほうに合わせたいときは、動画と音声の開始位置をそろえてから、タイムラインのツールバーのリンクのボタンか、右クリックの「映像と音声をリンク」でつなぎ直してください。
音声だけのファイル(m4a・mp3・wav など) 音声クリップとして取り込んだものからも字幕を作れます。会議の録音やポッドキャストなど、映像の無い素材にも使えます。映像の入っていない動画ファイル(音声だけの MP4 など)も、音声として取り込まれるので同じように使えます。
なお、字幕を作る前に雑音を減らしたり音量をそろえたりしたいときは、姉妹サービスの AudioBuff などで整えてから VideoBuff に取り込むのがおすすめです。